
顯微鏡下的畫面很安靜:兩枚尺寸相同的矩形,上下相疊。9 月 30 日,半導體分析機構 Kurnal Insights 公開了華為海思麒麟 9050 Pro 的裸晶顯微照(Die Shot),第一次從物理層面展示這枚晶片的內部結構。這類照片向來誠實,沒有行銷配色,沒有渲染圖,晶片只能用自己的版面交代自己。
兩枚相同的矩形
規格欄位寫得具體。每枚裸晶 11.13 × 10.84 mm,面積約 120.65 mm²。這個數字值得多看一眼:它甚至略小於前代麒麟 9030S 的 122 mm²。行業慣常的升級劇本是面積逐年變大,這一版的版面卻往回縮了 1.35 mm²。面積縮小的晶片要扛下更高的效能,靠的是整套布局語言的改寫。
兩枚裸晶分工明確。一枚承載核心計算邏輯,另一枚專責 SRAM 與快取,兩者以高密度垂直互連相接。這套上下相疊的結構,是華為「韜定律」之下「邏輯摺疊」(LogicFolding)技術第一次走進量產手機。
摺疊是一種排版決定
平面晶片的版面邏輯接近一張攤開的報紙:邏輯電路與 SRAM 並排列印,訊號沿著水平走線長距離移動。邏輯摺疊把這張報紙對摺,計算留在上層,記憶放到下層,原本橫穿整個版面的長線,換成極短的垂直通道。做過版面編輯的人對這個動作會很熟悉:把頁尾註釋搬到正文旁邊,內容一字不改,讀者往返的時間卻整個壓縮了。
工藝欄位裡也有選料的細節。依據 @Taog_1575 引用極客灣資料與裸晶照的解析,邏輯裸晶採中芯國際 N+3 製程,SRAM 裸晶採 N+2。同一枚晶片的兩層使用不同世代的製程,接近家具工匠的選料:桌面用硬木,抽屜內板用合板,把最貴的工序留給最需要精度的位置。這個分工也改寫了良率帳本。單顆裸晶面積縮小,良率理應優於麒麟 9030 Pro;但兩枚疊合封裝之後,封裝端的整體良率仍是未知數,供貨策略於是保守,這枚晶片只見於 Mate 90 Pro Max 及以上版本。
「摺疊」在手機產業原是螢幕的動詞,講鉸鏈,講摺痕,例如我們先前讀過的iPhone Duo 從摺痕讀起的互動設計。麒麟 9050 Pro 把同一個動詞搬進看不見的地方,摺的是訊號路徑與記憶版面。它也確實先在一支摺疊手機上亮相:9 月 7 日,麒麟 9050 Pro 隨三摺疊手機 Mate XT 2 首發,那是華為六年來第一次在旗艦發表會上推出全新麒麟晶片。摺疊手機裡裝著摺疊的晶片,命名與形態在同一場發表會上對齊。
密度欄位裡的 55%
效能升級最常見的表達是測試數字,這次最扎實的欄位卻是密度。依何庭波在中國科學院科技論文預發布平臺 ChinaXiv 上的署名論文,麒麟 9050 Pro 的等效電晶體密度,從麒麟 9030 Pro 的每平方毫米約 1.55 億個,提高到約 2.38 億個,增幅約 55%。寫論文的人也值得讀進脈絡:何庭波是華為董事、半導體業務部總裁,技術原理由她親自署名交代。
更反直覺的數字在功耗欄。在效能對齊的條件下,真實負載基準測試裡,NPU 功耗降低 66%,GPU 功耗降低 58%,CPU 效能核功耗降低 41%。按常理,密度攀升,功耗密度應同步走高,這份帳本卻往反方向傾斜。摺疊省下的長距離走線,原來都記進了能耗欄位。版面上的每一毫米,在電的世界裡都是時間與熱。
從幾何到時間,換一把尺
支撐這些數字的,是指導原則的替換。何庭波在論文裡提出,以「時間(τ)縮微」替代「幾何縮微」作為半導體演進的新指導原則,用邏輯摺疊等技術持續壓縮訊號傳播時延。τ 這個符號選得講究,在電路學裡它向來是時間常數的記號,RC 電路充放電的刻度,工程師一眼讀得出指涉。
換尺的意思是,量測對象從電晶體的線寬,改成訊號從發出到抵達的時間。尺一換,可用的手段跟著換:把電晶體畫得更小是一條路,讓訊號走更短的路是另一條。在前者受限的處境裡,垂直堆疊成為第一個成形的答案。
市場研究機構伯恩斯坦的報告稱這項進展為「被低估的突破」,同時把難題寫在同一頁:良率與散熱,是 3D 堆疊在大規模量產中仍要持續解決的兩道工程題。這份報告也給出量尺式的對照,麒麟 9050 Pro 把與蘋果的技術差距縮到約三年,上一代約四年。帳面上是漸進的一年;放在先進製程受限的脈絡裡,這一年是用架構與封裝換來的。
貨架上的分層
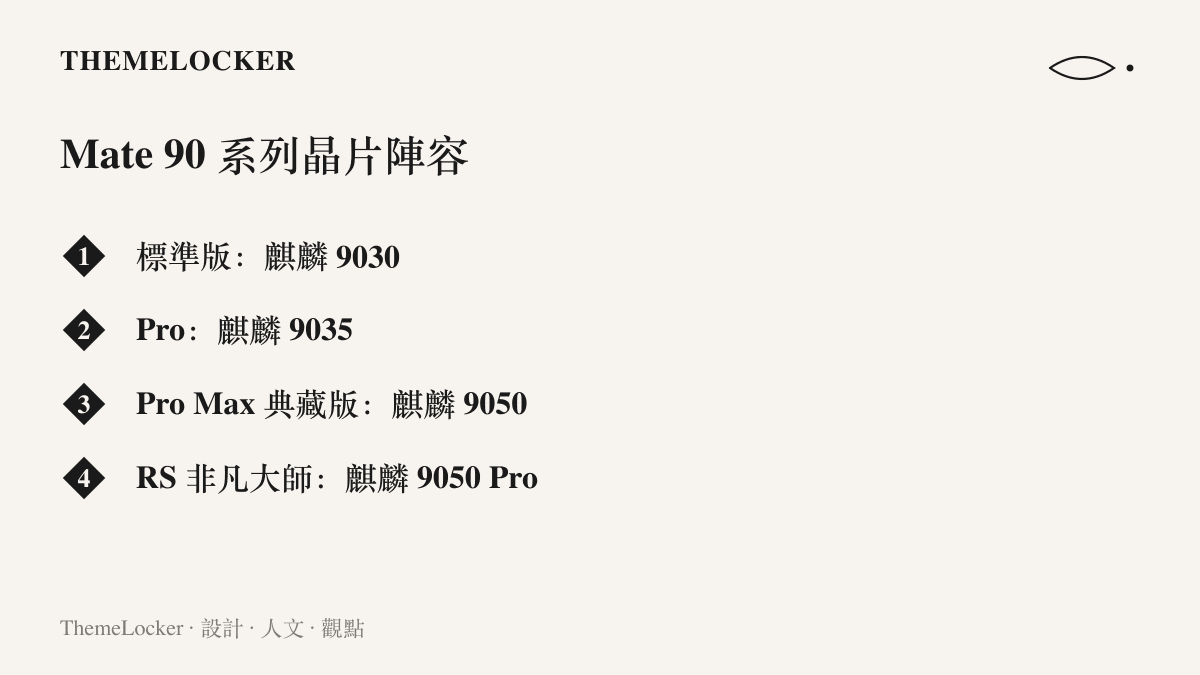
10 月 1 日的 Mate 90 系列發表會上,餘承東公布晶片陣容:標準版搭麒麟 9030,Mate 90 Pro 搭麒麟 9035,Pro Max 典藏版與 Mate 90 RS 非凡大師搭麒麟 9050 Pro。晶片在這裡是貨架分層的標記,型號欄位直接對應價格階梯的頂端。
發表會公布的整機效能數字裡有一處錯位:Pro Max 較上代提升 31%,標準版提升 27%,Pro 版提升 20%。標準版的增幅排在 Pro 之前,貨架邏輯在數字上露出毛邊,這也是分層設計裡常見的取捨痕跡。
規格表的其他欄位說明了省下來的空間與功耗花到哪裡去。麒麟 9050 Pro 整合靈犀 CPU 與馬良 GPU,NPU 沿用達芬奇架構;馬良 GPU 的計算單元與快取翻倍,NPU 支援在端側部署 30B 參數的混合專家架構大模型。
華為熟悉的差異化手法裡,有一路是外包給角色與包裝,我們先前讀過華為 nova16 與 Hirono 小野的聯名款設計,規格表原封不動,色彩交給 IP。麒麟 9050 Pro 走的是反方向的手工活,差異化往晶圓深處做,做進兩枚裸晶之間那條看不見的縫。
收在兩枚矩形之間
一張裸晶照能收進設計檔案的理由,在於它示範了版面重排的基本功。當一條軸線走不通,就把內容往另一個維度搬:地圖摺成口袋大小,卷軸裝訂成冊頁,都是同一個動作的舊版本。晶片用上它,因為平面已經排滿,而時間的欄位還有得擠。
剩下的考題屬於工程欄,良率與散熱會決定這條路能走多遠。設計欄位裡,答案已經印在顯微照上:兩枚相同的矩形,一枚管算,一枚管記,中間以最短的線互相說話。所謂邏輯摺疊,做的其實是一次誠實的排版,面積不夠,就把距離摺短。